

Исследователи из Alibaba Group и Skywork AI разработали Meissonic, используя уникальную архитектуру трансформации и новые методы обучения. Модель работает на средних игровых компьютерах и в перспективе может быть использована на мобильных телефонах.
Meissonic использует моделирование изображений с маской, когда части изображений скрываются во время обучения. Модель учится восстанавливать недостающие части на основе видимых областей и текстовых описаний. Это помогает ей понять взаимосвязь между элементами изображения и текстом.
Архитектура модели позволяет ей генерировать изображения высокого разрешения 1024 x 1024 пикселей: фотореалистичные сцены, а также стилизованный текст, мемы или мультяшные стикеры, как и гораздо более крупные модели.
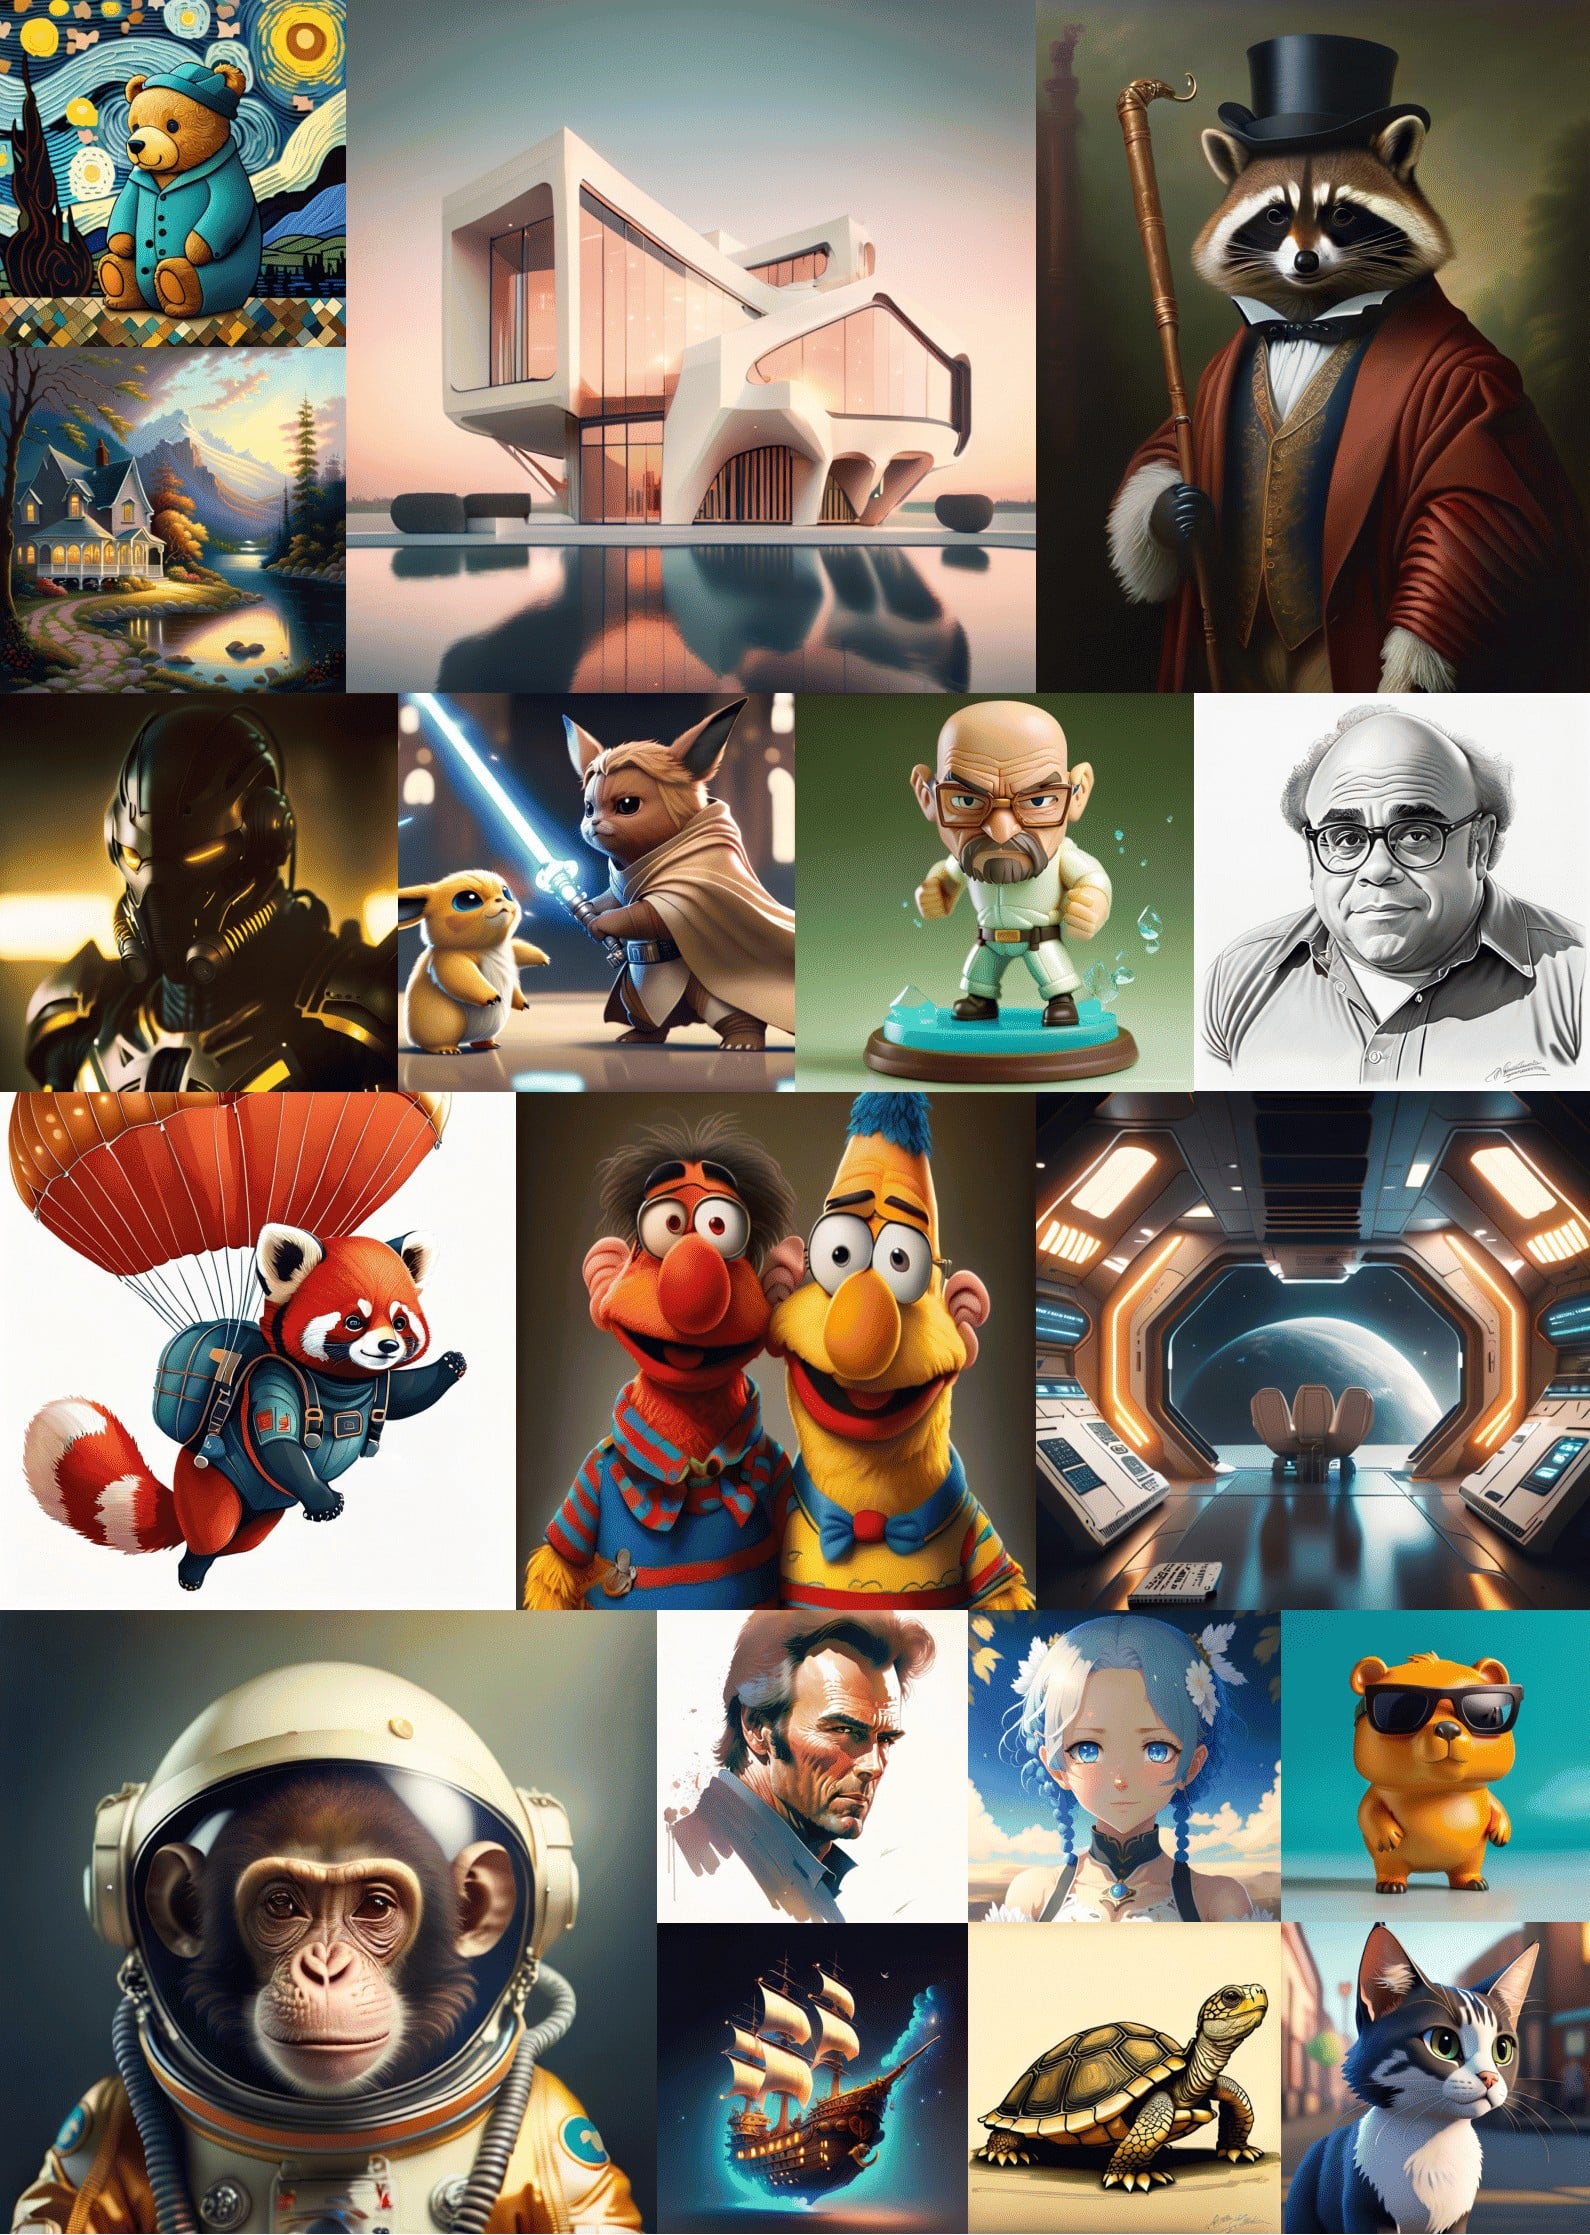
В отличие от типичных авторегрессионных моделей, которые генерируют изображения последовательно, Meissonic предсказывает все токены изображения одновременно путём параллельного итеративного уточнения.
По словам исследователей, такой неавторегрессионный подход сокращает количество шагов декодирования примерно на 99 %, что значительно ускоряет создание изображений.
Meissonic сочетает в себе мультимодальные и мономодальные слои-трансформеры. Мультимодальные слои отражают взаимодействие текста и изображения, а мономодальные — уточняют визуальные представления. Исследователи обнаружили, что соотношение между этими типами слоёв (1:2) является оптимальным.
Исследователи обучали Meissonic с помощью четырёхэтапного процесса. Сначала они научили модель основным понятиям, используя 200 миллионов изображений с разрешением 256 x 256 пикселей. Затем они улучшили понимание текста с помощью 10 миллионов тщательно отфильтрованных пар «изображение-текст» с разрешением 512 x 512.
На третьем этапе были добавлены специальные слои сжатия для получения изображения размером 1024 x 1024 пикселя. Наконец они провели тонкую настройку модели, используя низкие скорости обучения, и включили данные о предпочтениях пользователей, чтобы улучшить её производительность.
Несмотря на небольшие размеры, Meissonic превзошёл более крупные модели, такие как SDXL и DeepFloyd-XL, в бенчмарках, включая Human Preference Score v2. Он набрал 28,83 балла по HPSv2, что выше, чем у других моделей.
Meissonic также может выполнять inpainting и outpainting без дополнительного обучения. Исследователи приводят примеры изменений фона, стилей и объектов.
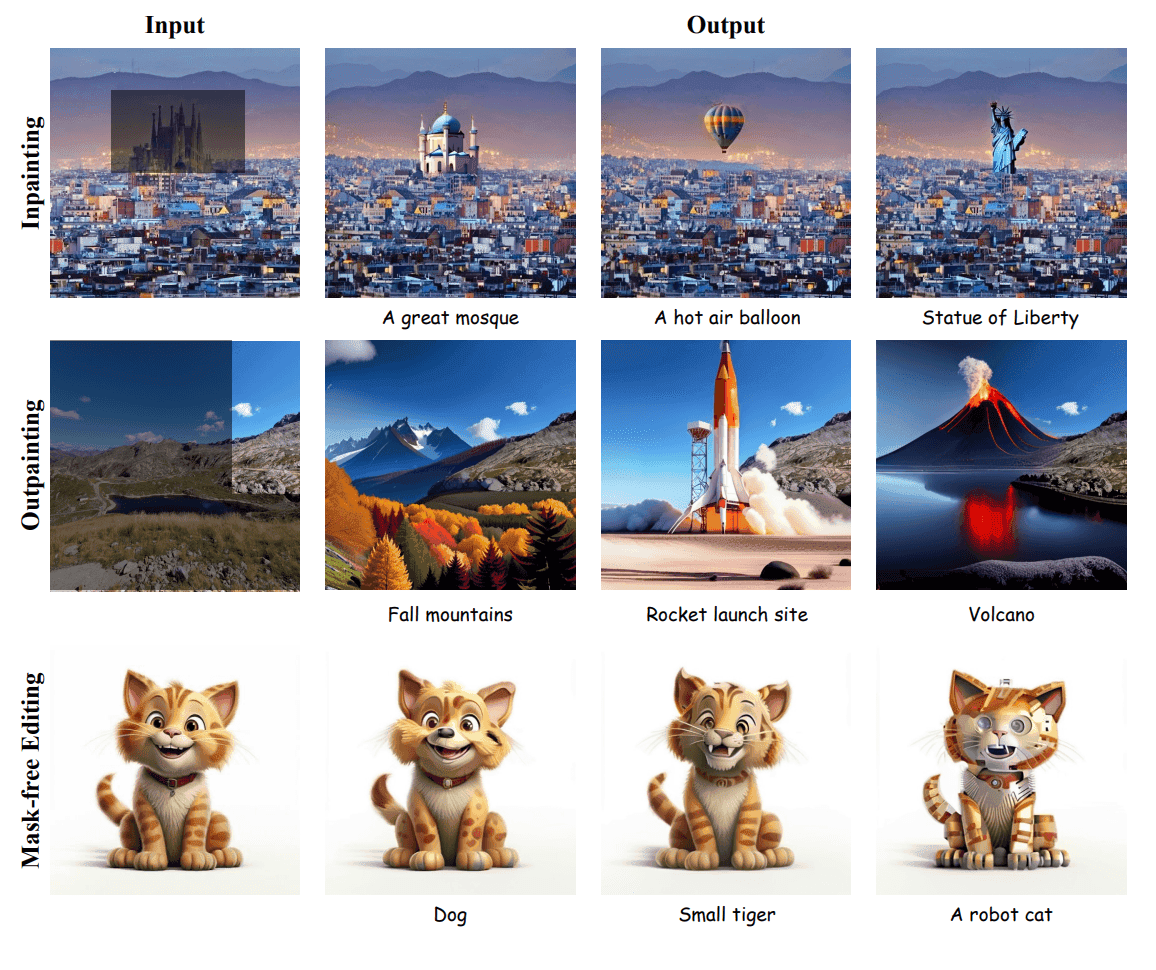
Исследователи полагают, что их подход может позволить быстрее и дешевле разрабатывать собственные генераторы изображений. Он также может способствовать разработке приложений для преобразования текста в изображения на мобильных устройствах.
Демо доступно на Hugging Face, а код доступен на GitHub. Модель работает на графических процессорах с 8 ГБ VRAM.

Материалы: The-decoder.com (Jonathan Kemper)